讲义 HTML(Online-Scheduling.html)第 1–187 页,第 15–20 页并入第 14 页的交互演示(slides 无页脚页码)
前三讲的在线问题都是”服务请求、付移动或缺页代价”。本讲换一类问题:在线调度。jobs 逐个到来,要立刻(或在合适的时刻)把它们分到机器上,目标是让最后完工的时间(makespan)尽量早。这也是负载均衡的模型:jobs 是任务,machines 是服务器。
全讲围绕两个下界展开:OPT 不能太小,因为工作量要摊到所有机器上(效率界);同时大 job 不能太多,因为两个大 job 落在同一台机器上就会撞破 OPT(组合界)。几乎所有上界证明都是”假设 ALG 很大,推出这两个界之一被违反”。
| 部分 | 模型 | 核心结论 |
|---|---|---|
| 1. 基本问题与 Greedy | 列表到达 + 相同机器 | Greedy 是 -competitive; 时最优 |
| 2. 打破 2:避免平坦 | 同上 | MR 算法 ;关键是不让所有机器一样高 |
| 3. 一般模型与技巧 | — | 机器类型 / 到达方式 / 目标;效率界、组合界、doubling、分层 |
| 4. 实时到达 | 实时到达 + 相同机器 | 在线 LPT 是 -competitive; 下界 |
| 5. 相关机器 | 列表到达 + 速度不同 | 改进的 Greedy 是 ;slow fit + doubling 是 |
| 6. 不相关机器 | 列表到达 + 任意 | 下界 ;指数势函数达到 |
1. 基本问题与 Greedy
1.1 在线 makespan 最小化
定义:Makespan 最小化(负载均衡)
- 输入: 台相同的机器, 个 job,job 的大小(处理时间)为 。
- 输出:把每个 job 分给一台机器,最小化 makespan,即所有 job 的最大完工时间。机器 的负载 是分给它的 job 大小之和,makespan 。
- 在线(列表到达,list arrival):job 逐个到来,每来一个必须立即且不可撤销地选定机器,然后才看到下一个。
离线版本已是 NP-hard( 时就包含 Partition),但有好的近似:LPT(Longest Processing Time first)先把 job 按大小降序排列,再依次放到当前负载最小的机器上,是 -近似。在线时无法排序,只能按到达顺序处理。
1.2 Greedy 是 -competitive
定义:Greedy(List Scheduling,Graham 1966)
每来一个 job,放到当前负载最小的机器上。
两个关于 OPT 的下界贯穿全讲:
- 效率界:(总工作量摊到 台机器上)。
- 单个 job:。
定理:Greedy 是 -competitive(Graham 1966)
证明
设决定 makespan 的机器上最后放入的 job 为 (之后到达的 job 不影响这台机器,可以删掉,不妨设它就是最后一个 job),它的开始位置为 ,即放入前该机器的负载,于是 。Greedy 选的是负载最小的机器,所以放入 时每台机器的负载都 。由效率界, 所以 ,即 。
粗略版本是 、,所以 。后面 LPT 和相关机器的分析都沿用这个框架:盯住”最后一个 job”,分别估计它的开始时间和它本身的大小。
分析是紧的:先来 个大小为 的 job,Greedy 把每台机器都堆到 ;再来一个大小为 的 job,。OPT 把小 job 平均放在 台机器上(每台 ),大 job 单独占一台,。比值 。
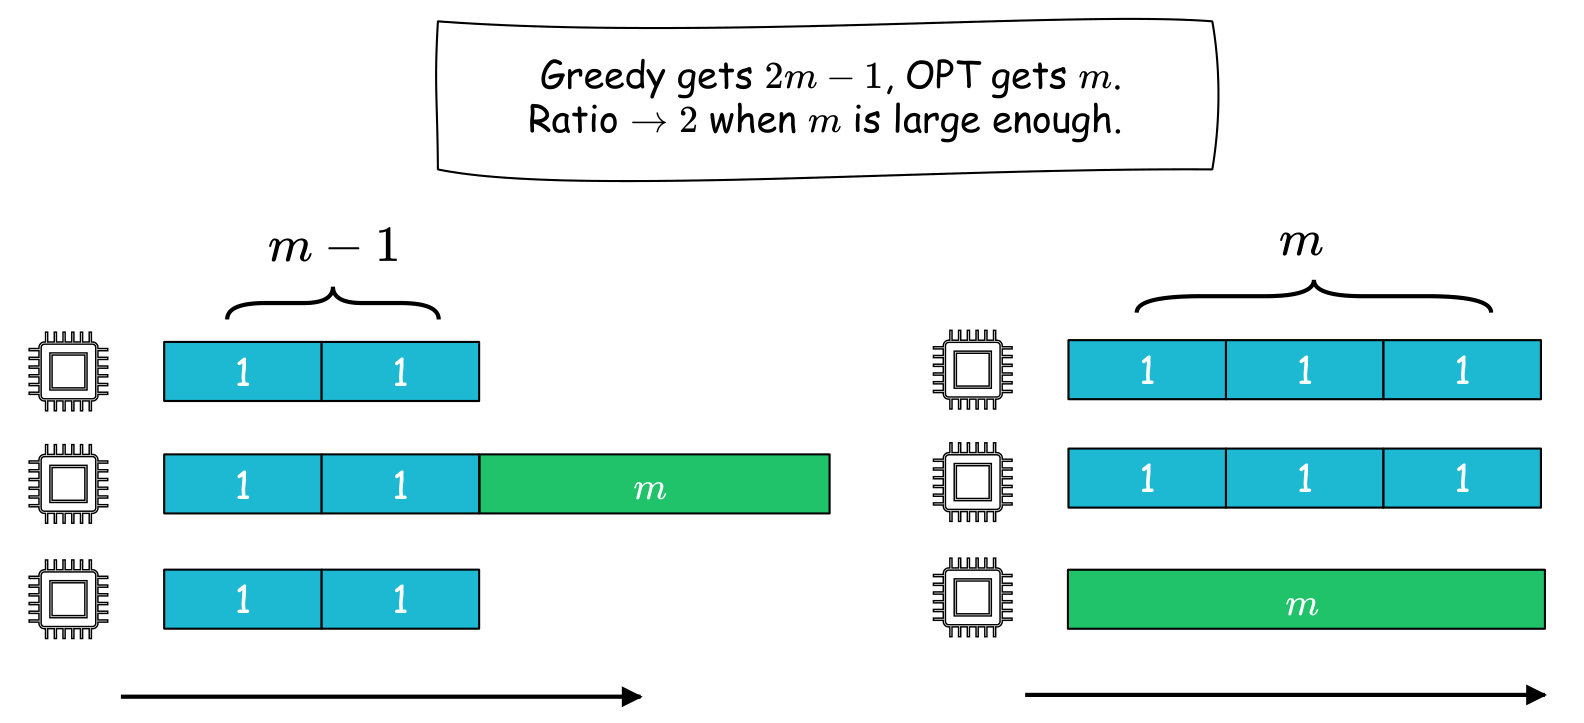
1.3 时 Greedy 最优
定理: 时任何确定性在线算法的竞争比
证明
先来两个大小为 的 job。确定性算法只有两种做法:
flowchart TD
  S["两个大小为 1 的 job"] --> A["放在同一台机器"]
  S --> B["各放一台"]
  A --> A1["停止:ALG = 2,OPT = 1,比值 2"]
  B --> B1["再来一个大小为 2 的 job:ALG ≥ 3,OPT = 2,比值 3/2"]
两种情况下比值都 。
所以 时 是最优竞争比。 很大时,能不能明显好于 ?
2. 打破 2:避免”平坦”的调度
2.1 已知结果
确定性算法,一般 :上下界目前是 。
| 年份 | 作者 | 结果 | 类型 |
|---|---|---|---|
| 1966 | Graham | ; 时最优 | 上界 |
| 1993 | Galambos, Woeginger | , | 上界 |
| 1995 | Bartal et al. | 上界 | |
| 1996 | Karger et al. | 上界 | |
| 1999 | Albers | 上界 | |
| 2000 | Fleischer, Wahl | () | 上界 |
| 2001 | Rudin III | () | 下界 |
随机算法:一般 时为 (下界 Sgall 1997,上界 Albers 2002)。
所有突破 的算法都基于同一个想法:避免平坦的调度。
2.2 为什么”平坦”危险
回看 Greedy 的紧例子:坏就坏在大 job 到来时所有机器一样高(都是 ),它放在哪里都会叠在高处。如果有几台机器保持很低,大 job 就可以放在低处,而不必叠到 之上。
所以来一个小 job 时有两种选择:
- Greedy:放在最低的机器上,当前代价小;
- Steep(陡峭):放在一台较高的机器上,故意保持一些机器很低,为将来的大 job 留位置。
决策规则大致是:
- 调度已经足够陡峭 → 不必再刻意保持,按 Greedy 放;
- 调度已经危险(再往高处放会超过目标比值)→ 按 Greedy 放;
- 其余情况 → 让调度更陡峭。
2.3 MR 算法
定义:MR 算法(Fleischer & Wahl, ESA 2000)
把机器按当前负载升序排列,机器 负载最小。前 台为 Light,其余为 Heavy。参数 ,,。新 job 到来时:
- 已经陡峭: → Greedy,放在机器 ;
- 已经危险: → Greedy,放在机器 ;
- 否则 → 放在机器 (最低的 Heavy 机器),使调度变陡。
其中 表示一组机器的平均负载。
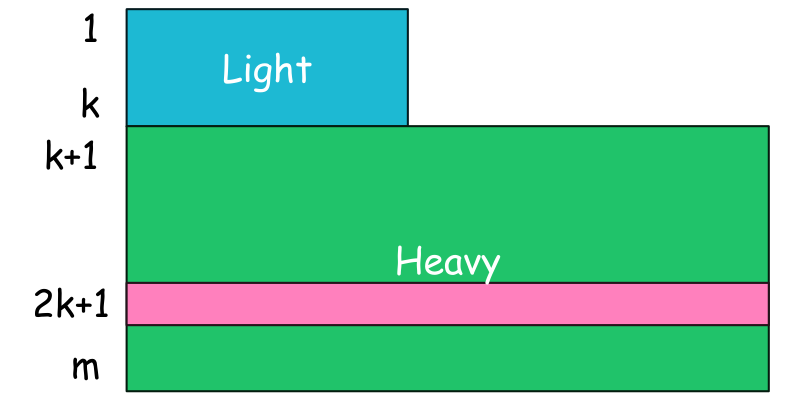
放在 而不是更高的机器,是因为它在 Heavy 中最低,代价最小;Light 机器则一直留着给大 job。条件”危险”保证这种刻意的不平衡不会直接把 makespan 推过 倍。
2.4 分析(只给框架)
完整证明很长,讲义只给思路。设存在最小反例:。设最后一个 job 决定了 makespan,开始位置为 ,于是 。
第一步: 是按 Greedy 放的。若它放在机器 ,说明不危险:,与 矛盾。所以它放在负载最小的机器 上,,此时所有机器的负载都 (称为都”满”了)。
再记两个简单事实:由 和 得 ;由效率界 。
第二步: 到来时调度一定是平坦的,即 。否则 。机器 的负载都 ,其余机器 ,由效率界
矛盾。这就是参数 的作用:陡峭的调度”浪费”了足够多的工作量,最后不可能还是坏情况。
第三步:找 个大 job。称 job 为大的,若 ()。若有 个大 job,必有两个落在 OPT 的同一台机器上,,于是 ,矛盾。
- 是大的:。
- 另外 个:每台机器最终都满了(负载 )。把一台机器”变满”的那个 job 称为 filling job,每台机器一个,共 个。要证明所有 filling job 都是大的。
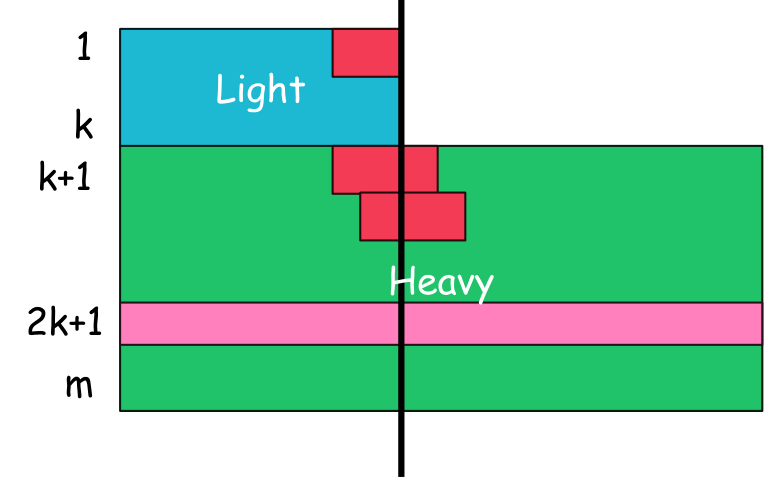
第四步:filling job 为什么大(只有直觉)。以最后一个 filling job 为例:
- 若 到来前调度平坦:MR 会把它放到 ,除非危险;它能填满某台机器,需要 ,即 。若 已经很小,填满它需要大 job;若 很大,则平均负载大, 也必须大。
- 若调度陡峭:最终调度是平坦的(第二步),从陡峭变到平坦需要足够多的工作量,而这时 保证很小,填满它的 job 必须大。
其余 filling job 的论证类似,但细节繁琐,略去。
思路:MR 的证明在做什么
想推出矛盾,就要用到两个下界之一:
- 效率界:陡峭的调度里,Heavy 机器比 Light 高很多,总工作量大,OPT 被迫变大。第二步说明坏情况的终局一定平坦。
- 组合界:平坦的终局里每台机器都满了,而每台机器的 filling job 都是大 job,加上 共 个,两个必须在 OPT 中同机,OPT 被迫变大。
算法的设计就是让每一种局面都至少被其中一个界”罚”到:要么调度陡峭,大 job 有低处可放;要么平坦,但那时 OPT 也不小。
3. 一般模型与技巧
3.1 模型的维度
机器不一定相同,job 也不一定一到就要决定:
| 维度 | 选项 | 含义 |
|---|---|---|
| 机器 | Identical | 所有机器相同,job 处理时间 |
| Related | 机器 有速度 ,处理时间 | |
| Unrelated | 每个(机器, job)对有自己的处理时间 | |
| 到达 | List arrival | job 逐个到来,立即决定 |
| Real-time arrival | job 在释放时间 出现,算法在任意时刻可以在空闲机器上开始一个 job | |
| 目标 | Makespan | |
| 总完工时间 | ||
| 总流时间 |
模型太多,本讲只讲 makespan,按以下顺序:
flowchart LR
  A["列表到达 + 相同机器<br/>Greedy 2−1/m,MR 1.92"] --> B["实时到达 + 相同机器<br/>在线 LPT 1.5"]
  A --> C["列表到达 + 相关机器<br/>Θ(log m) → 常数 8"]
  C --> D["列表到达 + 不相关机器<br/>Θ(log m)"]
3.2 常用技巧
- OPT 的下界
- 效率界:工作量不能太多, 总工作量 / 总处理能力。
- 组合界:大 job 不能太多,两个 的 job 不能同机。
- Doubling:先假设知道 OPT 的值设计算法,再用猜测并翻倍去掉这个假设(Lecture 1 线搜索的翻倍思想)。
- Grouping / 分层:把 job、机器或负载按量级分成若干层,每层损失一个常数,层数是 。
4. 实时到达 + 相同机器
4.1 模型
定义:实时到达的在线 makespan 最小化
- 台相同的机器;job 有大小 和释放时间 。
- 在时刻 算法才知道 job (及其大小); 的 job 尚不可见。
- 任何时刻都可以在一台空闲机器上开始一个已释放的 job(不可中断)。
- OPT 事先知道所有 job 的大小和释放时间,但同样不能在 之前开始 job 。
与列表到达的区别:决定的是何时开始、在哪开始,不必在 job 到达时立刻承诺。算法可以让 job 排队等待。
4.2 Greedy 与在线 LPT
Greedy(job 一到就放到当前最闲的机器上)仍然是 -competitive,原证明照搬;紧例子也照搬(所有 job 在时刻 按列表顺序释放)。
但实时模型允许等待:job 在 到来,若等到某台机器空闲的时刻 再决定,期间 可能又来了更长的 job,先做长的更好。这就是 LPT 的在线版本。
定义:在线 LPT
每当一台机器在时刻 空闲且有待处理的 job,就在它上面开始当前最长的待处理 job。
在线 LPT 不会在有待处理 job 时让机器闲着,只是把”选哪个 job”推迟到机器空闲时。它化解了 Greedy 的紧例子:
- 若大 job 也在时刻 释放,LPT 先做它,正好是 OPT。
- 若对手推迟大 job(如 ),OPT 也只能从 起做它,;而 LPT 在时刻 就能开始它,,比值趋于 。
定理:在线 LPT 对所有 都是 -competitive(Chen & Vestjens 1997)
4.3 证明框架
设 job 在 ALG 中最后完工,开始时刻为 ,。反设 。
照搬 Greedy 的框架会得到"",但这在实时模型中可能是错的: 之前机器可能有空闲(job 还没释放),工作量不足以推出 。先假设没有空闲,看证明的主干;再处理空闲。
引理 1:最后的 job 等了超过
证明
(OPT 也要在 之后做完 ),而 ,两式相减。
在 内一直待处理,LPT 却没开始它,所以这段时间所有机器都忙。忙的是什么 job?
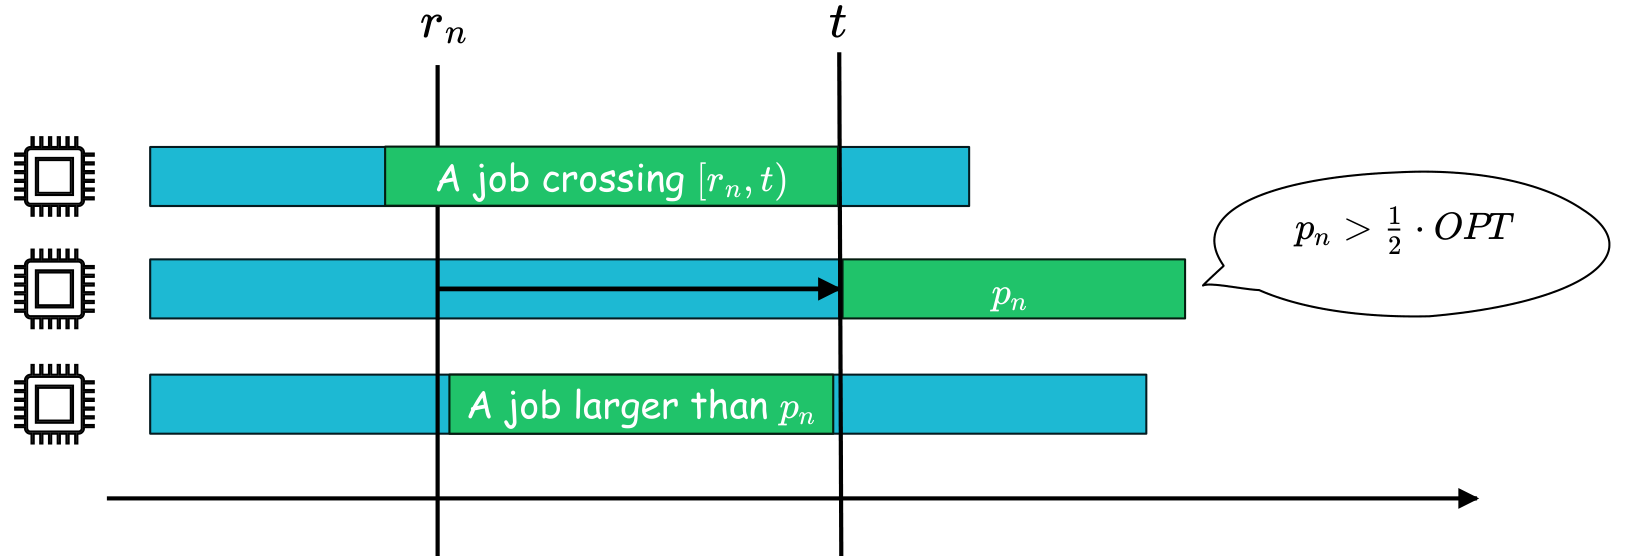
引理 2: 个"拦路"的 job
每台机器 上都有一个 job ,满足以下之一:
- (a) 在 内开始:则 ;
- (b) 机器 在 内没有开始任何 job:则有一个 job 贯穿整个 ,。
证明
(a) 开始 时 已释放且在等待,LPT 选最长的,所以 。(b) 机器一直忙又没有新开始的 job,只能是同一个 job 从 之前一直做到 之后。不同机器上的 互不相同。
情形 A:。 个 都 ((a) 型 ,(b) 型由引理 1),加上 共 个大于 的 job。由鸽巢原理,OPT 中有两个在同一台机器上,这台机器的负载 ,矛盾。
情形 B:。若 ,则 ,矛盾。但如上所说, 不一定成立,需要处理空闲。
4.4 处理空闲:情形 B 的严格证明
令 为 之前最后一个空闲区间的结束时刻(某台机器空闲的最后时刻;若从未空闲则 )。于是 内所有机器都忙。
基本事实(F):LPT 只在没有待处理 job 时才让机器空闲,所以 之前释放的 job 在 时都已开始(忽略端点情形)。特别地 。
情形 B 的证明分成两个断言,分别改进""和"",两者相加正好是 :
断言 A:
断言 B:
于是 ,矛盾。定理得证。
断言 A 的证明
设 为在 之前开始、在 时仍在运行的 job(跨过 的 job)。 之前一刻有一台机器空闲,所以 。对 ,记它在 ALG 中的延迟 ( 为开始时刻),( 为空时 ),对应的 job 称为”最受延迟的 job”。
(i) 。ALG 在 内做了 的工作,来自两类 job:
- 之后开始的 job:由 (F),它们在 之后才释放,OPT 也必须在 之后做;
- :OPT 最早从 开始做它, 之前至多做 ,所以 之后至少还要做 而 不小于 ALG 在 内对 做的工作。
所以 OPT 在 之后的工作量 ,摊到 台机器上:。
(ii) 。最受延迟的 job 在 内一直等待,这段时间所有机器都忙,ALG 做了 的工作;这段时间在 之前,与 不相交。总工作量 ,由效率界得到 (ii)。
两式相加:。
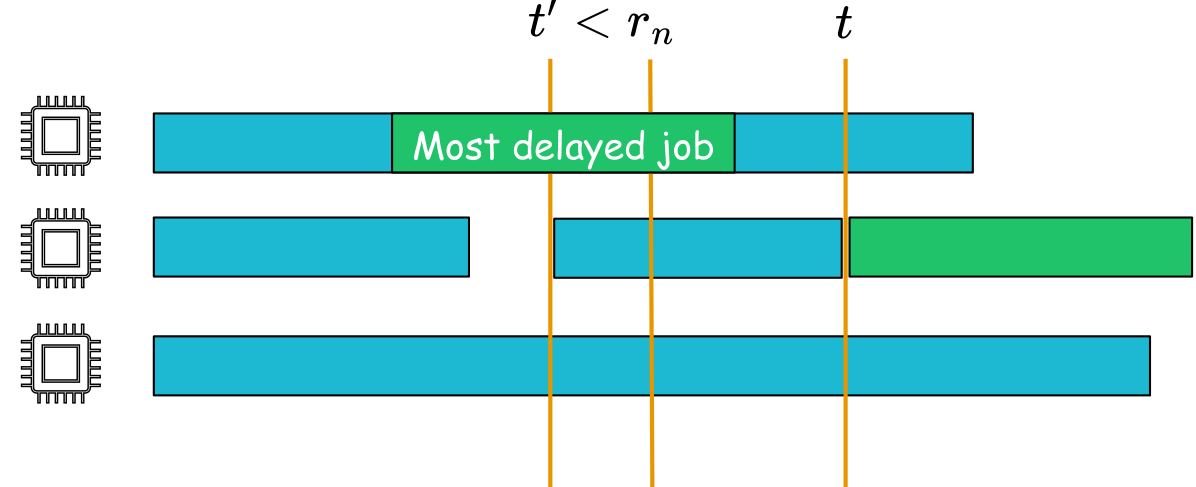
断言 A 的意思是:空闲会让 超过 OPT,但超出部分至多是 。直观上, 前的空闲说明 OPT 在 之前也”没多少事可做”,而 之后 ALG 一直忙;唯一能让 OPT 提前做掉的,是那些在 ALG 中被延迟、跨过 的 job,而延迟本身又意味着 之前有一段全忙的时间。两种情况此消彼长,取平均得到 。
断言 B 的证明
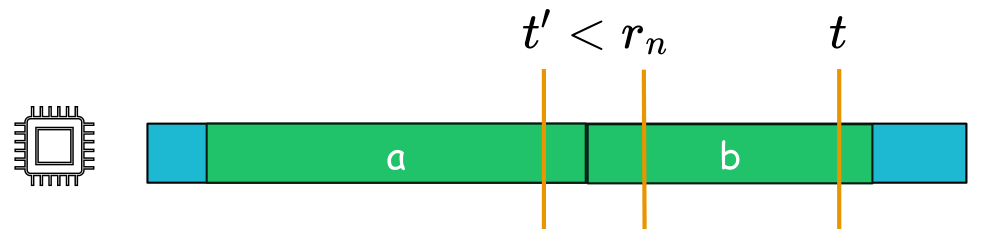
反设 。引理 2 的 个 job 加上 ,每个都 :(a) 型 ;(b) 型 。OPT 中必有两个在同一台机器上,设先做 后做 ,于是 。
- 若 :,矛盾。
- 若 : 和 (a) 型 job 都在 之后开始,由 (F) 它们在 之后释放,所以 是 (b) 型:在 之前开始,贯穿 , 且 。另一方面 ( 是 、(a) 型,或 的 (b) 型)。于是 等待了超过 ,所以 内所有机器都忙; 内也都忙,长度 (引理 1)。两段不相交(),ALG 的总工作量 ,与效率界矛盾。
Remark
讲义第 73 页由 、、 推出的应是 (两式相减),页面上写成了""。后续”两块忙碌区域各 → 矛盾”用的正是""。讲义还引入了 (最后一个空闲区间的开始)来说明 ;上面的证明只需要 ,所以省去了。
思路:LPT 的 1.5 从哪里来
,把 和 分别和 OPT 比较:
- 若 大(): 等了很久,等待期间每台机器都被一个”不比 短”或”比等待时间还长”的 job 占着,凑出 个大 job,组合界矛盾。
- 若 小:本来只要 就完了,但空闲会破坏效率界。于是用最后一次空闲的结束时刻 把两边都改进一点: 至多多出 (断言 A), 至多 (断言 B,还是组合界,只是只看 之后)。 在两式中正好抵消。
4.5 下界: 时不能好于
先试老办法。时刻 来两个大小为 的 job,想说”算法只有两种选择”。但实时模型下这不成立:算法还可以等待(选择 C)。若在等待期间对手放出一个大小为 的 job,算法就先做它,对手占不到便宜;若对手一直不放,等待本身又增加了 ALG 的代价。对手必须根据算法何时开始来出招,需要一个带参数的构造。
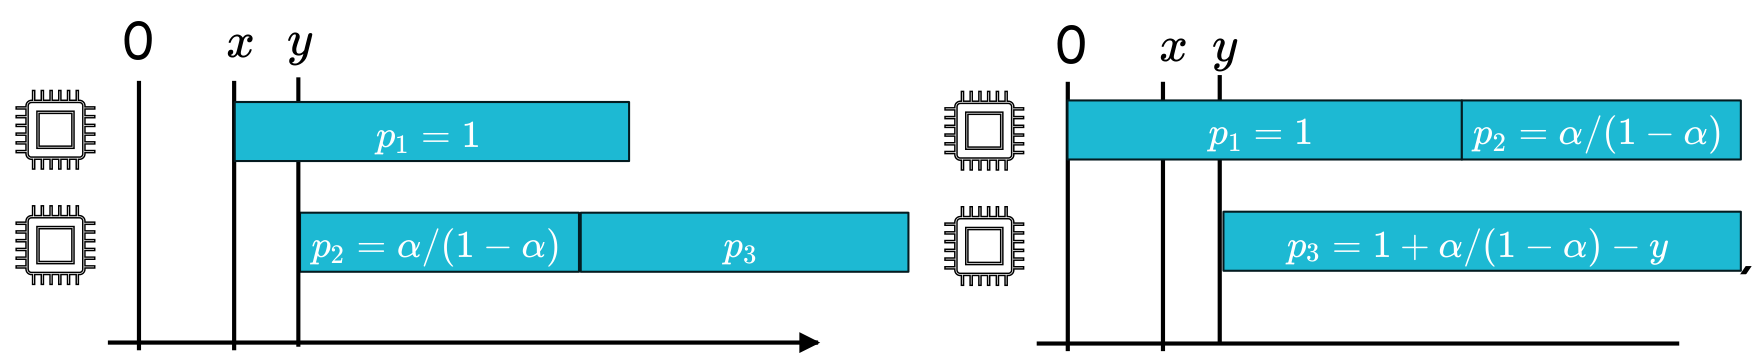
新构造(参数 待定,目标是证明竞争比 ):
- 时刻 释放 。设 ALG 在时刻 开始它。若 ,不再释放任何 job,,,完成。下面设 。
- 时刻 释放 。设 ALG 在时刻 开始 。令 。
情形 1:( 开始得早)。在时刻 释放 。
- OPT:一台机器做 再做 ,在 完工;另一台从 起做 ,同样在 完工。。
- ALG:时刻 两台机器都在忙( 做到 , 做到 ), 至早在 开始:
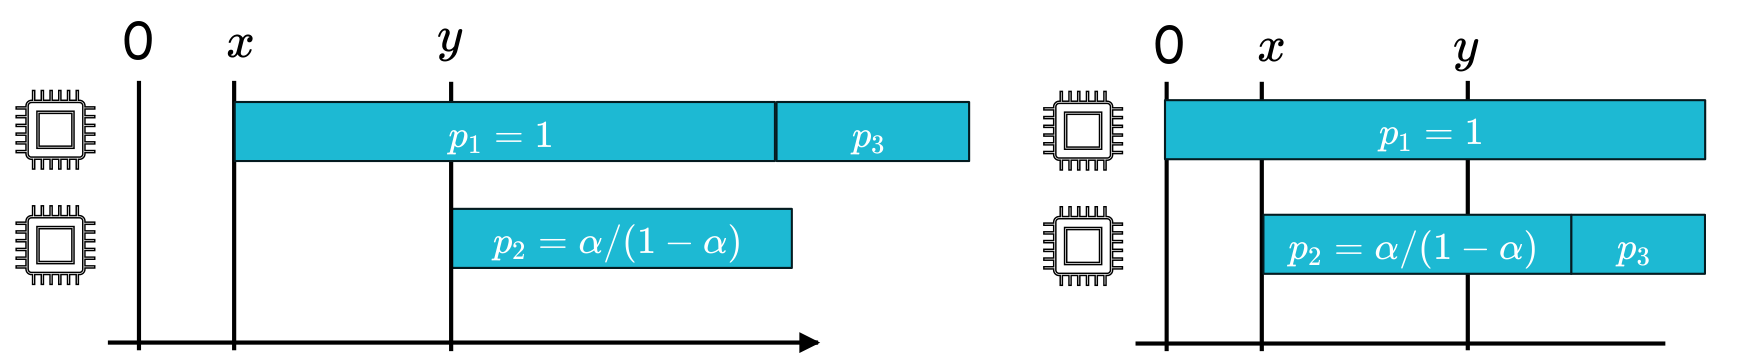
情形 2:( 开始得晚)。在时刻 (此时 ALG 还没开始 )释放 。
- OPT:一台机器从 做 ;另一台从 做 再做 ,在 完工。需要 的释放时刻 ,即 ;取下面的 时 ,成立。所以 。
- ALG:时刻 时 都未开始, 占着一台机器到 。要么 都放在另一台机器,完工 ;要么其中一个排在 之后,完工 。所以
选 :让情形 2 的比值也等于 : 所有 job 大小必须为正( 需要 ,即 ),只能取 。此时 ,并且情形 2 中 恰好等价于 ,与第 1 步一致。
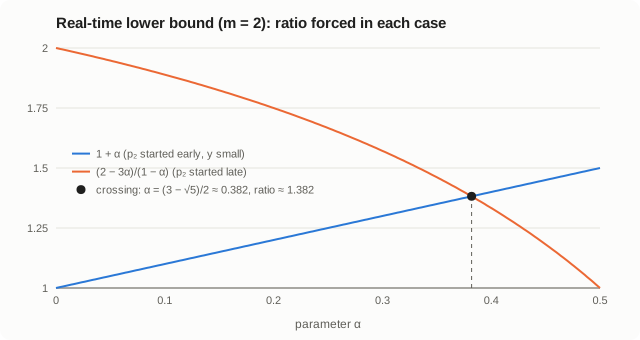
图中,蓝线是 ALG 早开始 时被迫的比值,橙线是晚开始时的比值。ALG 可以选择落在哪种情形,所以对手能保证的是两者中较小的那个;它在两线交点处最大。
定理:实时到达、 时,任何确定性在线算法的竞争比
4.6 更多结果
- 任何确定性在线算法, 时竞争比 (Chen & Vestjens 1996)。
- 时,SLEEPY 算法达到 ,与下界匹配(Noga & Seiden 1999)。
- 公开问题:一般 时能否击败在线 LPT 的 (讲者称是进行中的项目)。
5. 列表到达 + 相关机器
5.1 模型与已知结果
回到列表到达(立即且不可撤销地分配)。机器 有速度 ,job 在其上的处理时间为 。机器按速度降序编号:。
| 类型 | 区间 | 代表结果 |
|---|---|---|
| 确定性 | 上界 (Aspnes et al. 1993)、(Berman et al. 2000);下界 (Ebenlendr & Sgall 2012) | |
| 随机 | 上界 (Berman et al. 2000);下界 (Epstein & Sgall 2000) |
单 job 下界变为:(放在最快的机器上也要这么久)。效率界变为:。
5.2 Greedy 不再好用
“放到当前负载最小的机器”忽略了速度。,,来一个大小为 的 job:两台机器负载都是 ,Greedy 可能把它放到慢机器上,,而 。
定义:改进的 Greedy(看完工后的负载)
把 job 放到使 最小的机器 上, 为机器 当前的负载(总处理时间)。
它解决了上面的例子。它有多好?
5.3 改进的 Greedy 是 -competitive
从最后时刻出发。设 makespan 由机器 决定, 是放到 上的最后一个 job,于是 。Greedy 没有把 放到机器 ,所以
对最快的机器,,所以 。对较慢的机器只能得到 ,速度越慢下界越差。
若所有机器的负载都接近 ALG,效率界就会给出矛盾。问题是:要有多少台机器负载接近 ALG?
- 若只知道快机器的负载大,而 的机器只有 台:即使这些机器的负载都 ,总量也只有 ,OPT 可以把工作分给所有 台机器,没有矛盾。所以必须对大部分处理能力都给出负载下界。
- 想要的图景是:速度每减半,负载下界只损失一个常数倍的 OPT。速度跨越 到 共 个量级,总损失 。
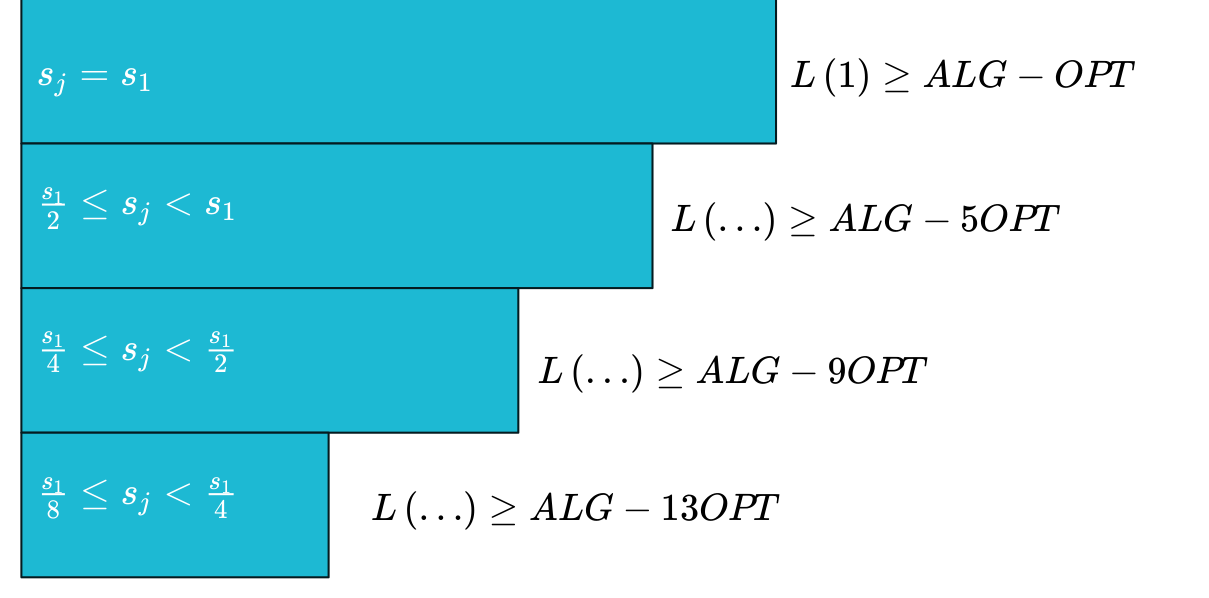
引理 1:速度减半,负载下界只损失
若所有 的机器都满足 ,则所有 的机器都满足 。
证明
不妨设 (否则结论平凡)。令 。考虑 ALG 放在 中机器上、并且完工位置高于 的 job。在每台 上,它们覆盖了负载区间 ,长度 ,所以总大小 。对 求和,这些 job 的总大小 ,而 OPT 在 上至多能处理 。所以其中某个 job 被 OPT 放在了 之外、速度 的机器上,于是 。
对任何 的机器 ,。ALG 放 时选了 中的某台 而不是 ,所以 即 。
引理 2:对所有 ,
证明
起点:所有 的机器满足 (上面”最后时刻”的论证)。用引理 1 把 依次取 ,每次损失 ,经过 次覆盖所有 的机器。
定理:改进的 Greedy 是 -competitive
证明
设 。若 ,由引理 2, 中每台机器的负载都 ,所以 job 总大小 。
另一方面,OPT 的总处理能力为 其中慢机器()至多 台,总速度 ,而 本身就在 中。OPT 处理不完所有 job,矛盾。所以 。
5.4 分析是紧的
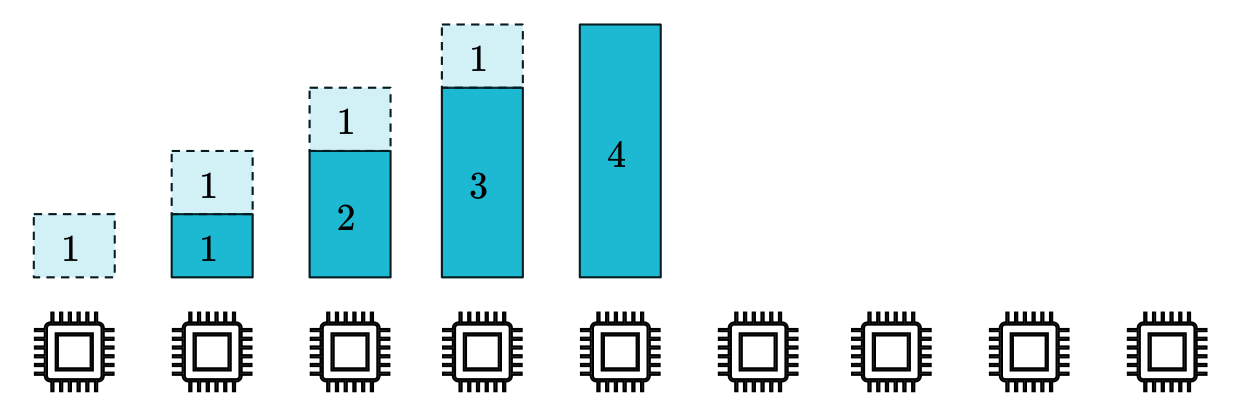
能否真的构造出”速度每减半,负载就减少一个常数”的局面?构造 层机器:
- 第 层有 台速度 的机器,,并让每层的总速度等于比它快的所有层的总速度之和:。于是 , 时 ,即 ,,,。
- 第 层对应 个大小为 的 job,每个在本层机器上恰好用时 ,所以 。
- 到达顺序:最小的(第 层的)job 先来,第 层的 job 最后来。
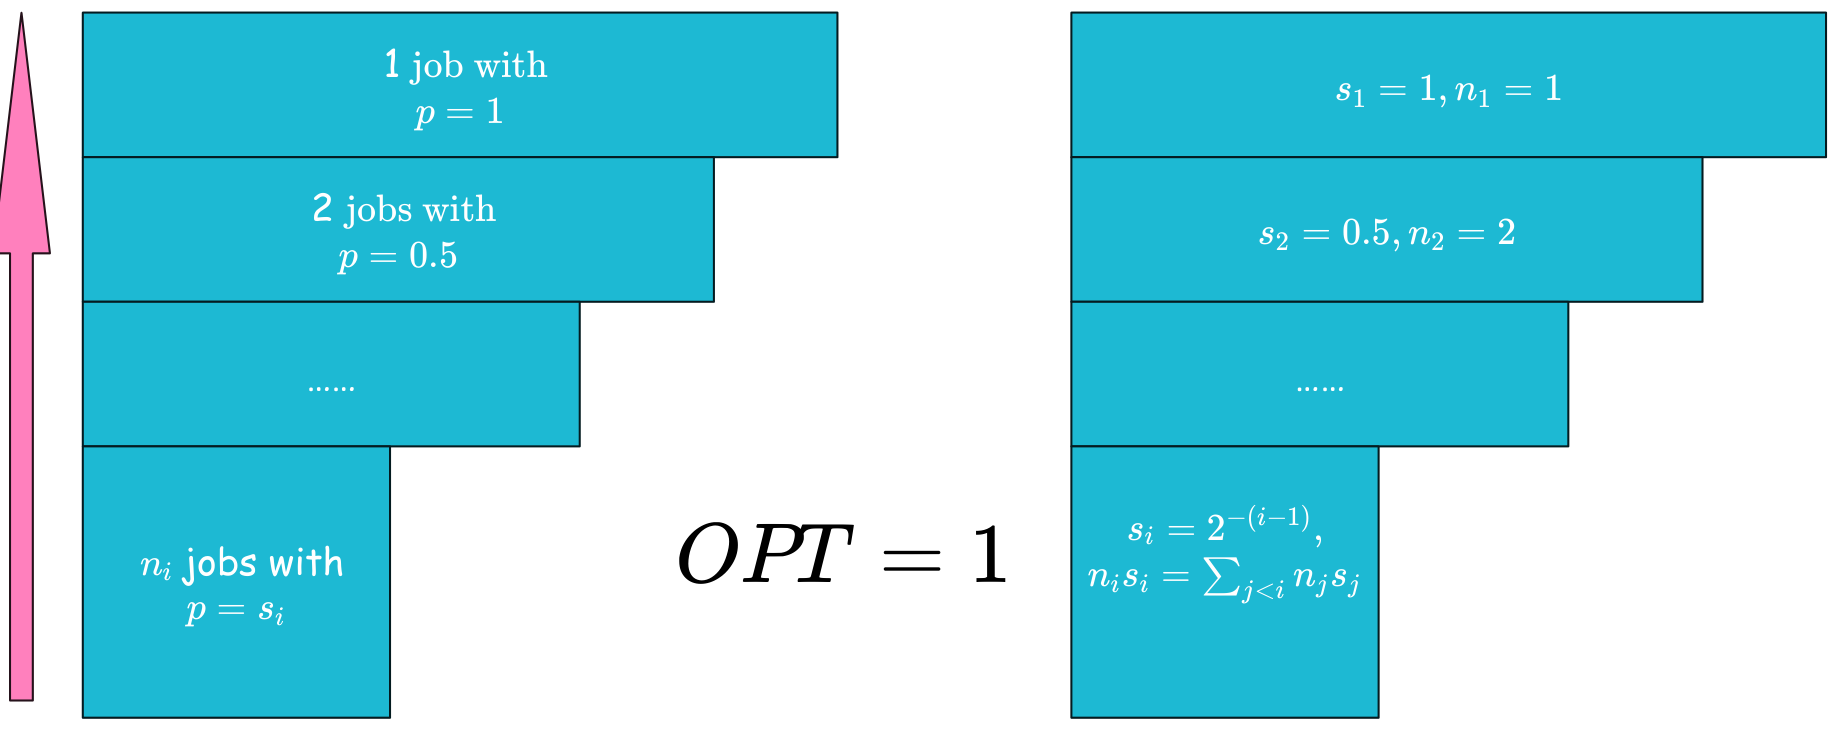
ALG 的表现(平局时偏向快机器,也可以对 job 大小做微小扰动来消除平局):
- 第 层的 job 先到。放在更快的机器上完工更早,于是它们把第 层的机器都填到负载 。它们的总大小 恰好等于这些机器的总速度,正好填满。
- 第 层的 job 到来:放在本层机器上完工于 ;放在第 层的机器上,完工也不超过 。于是它们把这些机器填到负载 。
- 依此类推,每一批 job 把所有更快的机器再抬高 。第 层的 job 处理完后,机器 的负载为 。
所以 ,而 。问题出在 Greedy 太快地使用快机器:快机器被小 job 占满,真正需要它的大 job 来了却没有位置。
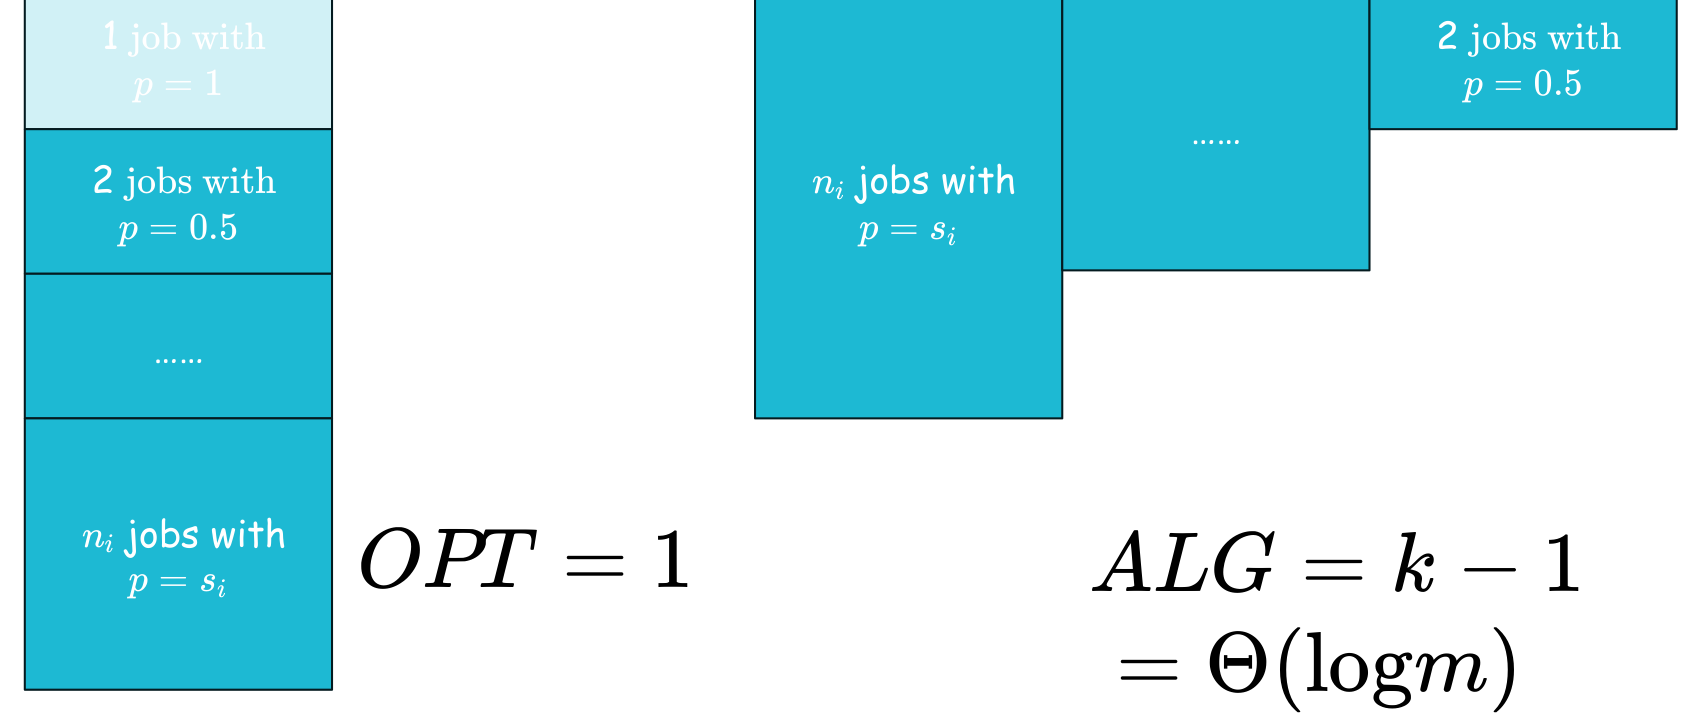
5.5 Slow fit:知道 OPT 时 2-competitive
能达到常数吗?平衡在于:
- 太快:把太多 job 放在最快的机器上(上面的坏例子);
- 太慢:把太大的 job 放在慢机器上(5.2 的坏例子)。
需要定义”合理的慢”。先假设知道 OPT 的值。
定义:Slow fit
称机器 对 job 可行,若 。把 放到最慢的可行机器上(速度相同时取编号最大的)。
只要每次都有可行机器,所有负载就 ,slow fit 是 -competitive。因为 ,只需证明最快的机器始终满足 ,它就始终可行。
引理:slow fit 运行中始终有
证明
反设某时刻 。对 归纳证明此刻 都 ,到 时得到矛盾。
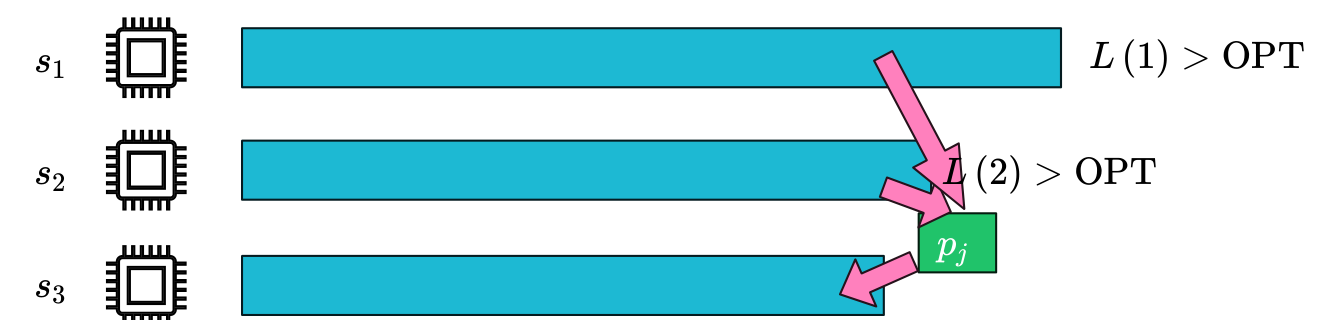
设 。ALG 放在机器 上的 job 总大小 ,而 OPT 在这些机器上至多处理 。所以其中某个 job (ALG 放在某台 上)被 OPT 放在了某台 上,于是 slow fit 选的是最慢的可行机器,却选了比 快的 ,说明当时机器 不可行:,所以 。
当 时,所有机器的负载都 ,job 总大小 ,OPT 无法完成,矛盾。
5.6 不知道 OPT:Doubling
定义:Slow fit + doubling
- 初始猜测 ()。
- 第 阶段:以 代替 OPT 运行 slow fit,可行性只计算本阶段放入的 job 的负载:。
- 若某个 job 找不到可行机器,令 ,开始新阶段(负载计数清零,该 job 在新阶段重新放)。
定理:slow fit + doubling 是 -competitive(Aspnes et al. 1993)
证明
上面引理的证明只用到”所有 job 能在 时间内完成”,所以只要猜测 ,该阶段就不会失败。设最后阶段为 :若 ,第 阶段失败说明 ,所以 ;若 ,。
第 阶段给每台机器增加的负载 ,所以
这与 Lecture 1 线搜索的翻倍一样:几何级数的和被最后一项控制,代价只多一个常数倍。
思路:从 到常数,改的是什么
改进的 Greedy 只看”放在哪里完工最早”,于是快机器总被小 job 占满。紧例子正是利用这一点:每来一批小 job,就把所有更快的机器抬高一层,共 层。
Slow fit 反过来:在不超过 的前提下尽量用慢机器,把快机器留给只有快机器才能及时处理的大 job。证明的核心是”快机器不会被占满”:若机器 超过 OPT,那么一定有某个 job 本可以放在更慢的机器上(OPT 就是这么放的),slow fit 没放,只能是因为那台慢机器也超过了 OPT;如此一路推到所有机器都超过 OPT,与效率界矛盾。
6. 列表到达 + 不相关机器
6.1 模型
定义:不相关机器
job 在机器 上的处理时间 任意(可以是 ),,目标仍是 。
两个典型特例:
- 相关机器:。
- 受限机器(restricted assignment):,每个 job 只能放在部分机器上。更特殊的是 one-infinity:,即单位 job 加上可用机器的限制。
即使是 one-infinity 也已经很难:竞争比必须是 。
6.2 下界
构造:每轮淘汰一半机器
设 为 的幂。第 轮开始时有 台”存活”机器,来 个单位 job,每个都可以放在任意一台存活机器上。ALG 分配完后,对手淘汰一半存活机器,保留总负载较大的一半。共进行 轮。
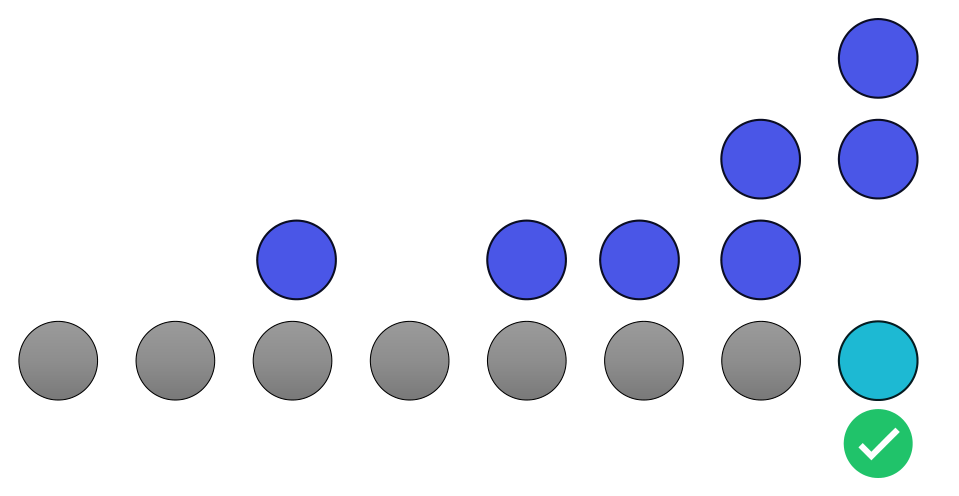
OPT :每一轮的 个 job 恰好放到这一轮被淘汰的 台机器上,每台一个。被淘汰的机器以后不再可用,所以不会冲突。
ALG 很大:设一轮开始前存活机器的平均负载为 ,这一轮后总负载为 。保留的一半总负载至少是一半:
轮后只剩一台机器,负载 。
定理:one-infinity 情形下,任何确定性在线算法的竞争比
随机算法也一样:由 Yao 原理,改为每轮淘汰均匀随机的一半存活机器。对任何确定性算法,随机一半的总负载期望恰好是一半,;而每个输入上都有 。所以 ,随机算法也是 。
6.3 受限机器:Greedy 达到
定义:Greedy(受限机器)
把 job 放到当前负载最小的可行机器()上。
下面对 one-infinity 证明(单位 job,OPT 为整数)。
分层:把负载按 OPT 切成层,第 层是高度 的部分,每台机器每层至多放 个 job。记
- :第 层的 job 数;
- :第 层之上的 job 数,, 是 job 总数。
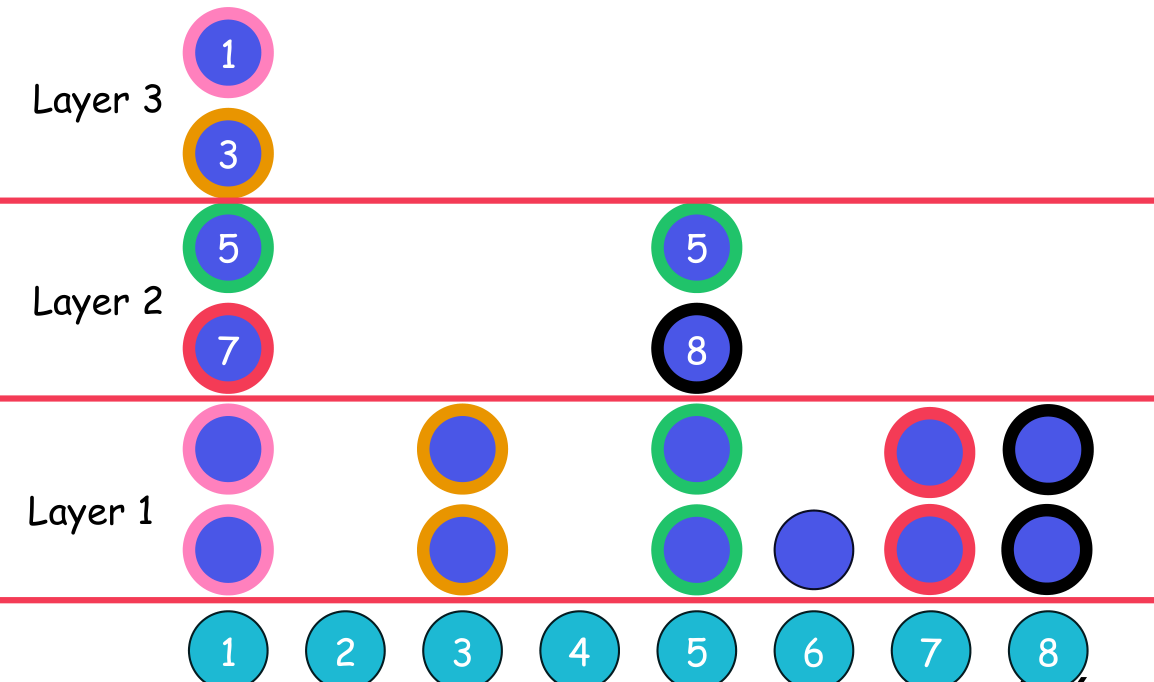
引理: ,因此
证明
取一个在第 层之上的 job,它在 ALG 中放入前所在机器的负载 ;Greedy 选的是可行机器中负载最小的,所以当时它的所有可行机器负载都 ,第 层都已放满 个 job。特别地,OPT 给它安排的机器第 层是满的。
OPT 的每台机器至多承接 个 job,所以这 个 job 在 OPT 中至少分布在 台不同的机器上,每台在 ALG 中第 层都有 个 job。所以 ,从而 。
定理:Greedy 对受限机器是 -competitive
证明
若 ALG 超过 ,则 ;由引理的论证,第 层有一台机器是满的,。而 ,所以 ,即 。所以 。
与 6.2 的下界一起,受限机器的竞争比是 (Azar, Naor & Rom 1992)。
6.4 一般不相关机器:Greedy 很差
“放到完工后负载最小的机器”在一般情形下只有 :
- job :,。Greedy 放到机器 (负载 )。
- job :,。放到机器 会到 ,Greedy 放到机器 (负载 )。
- job :,。机器 已有负载 ,Greedy 放到空的机器 (负载 )。
最终机器 负载为 ,而 OPT 把 job 放在机器 上,。竞争比 。
问题在于 Greedy 只顾平衡,不顾”这台机器是否适合这个 job”:每个 job 都放在了比最合适的机器慢得多的机器上,不断累积。
6.5 指数势函数算法
两种贪心各有道理:
- Greedy 1:完工后负载平衡(只看 );
- Greedy 2:选最合适的机器(只看 最小)。
负载接近时应偏向第二条,负载差距大时应偏向第一条。用指数势函数统一二者。归一化使 (OPT 未知时用 doubling)。
定义:指数势函数算法(Aspnes et al. 1993)
取 ,机器 的势为 。job 到来时,选使势能增量 最小的机器, 为放入 job 前的负载。
是两项之积: 惩罚已经很高的机器, 惩罚不合适的机器。若改用线性势函数 ,增量就是 ,退化为 Greedy 2。
定理:取 ,
证明
记 为算法给 job 选的机器, 为 OPT 选的机器, 为最终势能。
总增量:按机器分组望远镜求和,
用 OPT 的选择控制每个增量:算法选的是增量最小的机器,负载又只增不减,所以 对 求和,按 OPT 的机器分组:
用 OPT :OPT 的每台机器上 ,每个 。由凸性, 时 (弦在凸函数上方),所以内层和 。于是 取 :,即 。每台机器 ,所以 。还原到原来的单位即得定理。
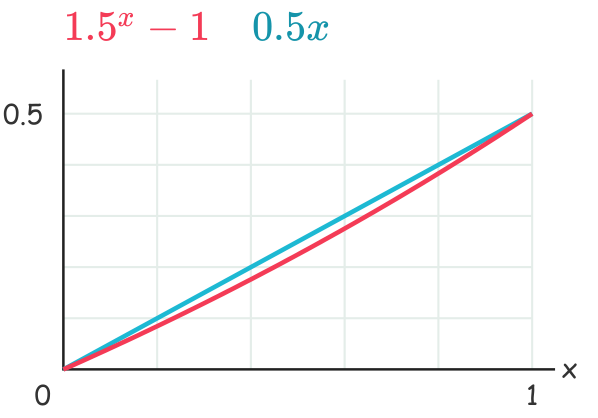
思路:为什么用指数势函数
想要的是” 小”,但 max 不好逐步分析。 是 max 的光滑替代:,所以只要 ,就有 。
分析是”和 OPT 逐个 job 比较”:每个 job 的势能增量不超过放到 OPT 那台机器上的增量;后者按 OPT 的机器加起来,每台机器上 OPT 的总处理时间 ,所以至多是这台机器势能的 倍。总增量 被 控制, 取得接近 就能把 钳住。 也不能太接近 : 会变大。 是一个方便的折中。
7. 小结
| 模型 | 本讲的算法 | 上界 | 本讲的下界 |
|---|---|---|---|
| 列表到达 + 相同机器 | Greedy;MR | ; | ();已知 |
| 实时到达 + 相同机器 | 在线 LPT | () | |
| 列表到达 + 相关机器 | 改进的 Greedy;slow fit + doubling | ; | Greedy 的紧例子 |
| 列表到达 + 受限机器 | Greedy | (随机也成立) | |
| 列表到达 + 不相关机器 | 指数势函数 | 同上 |
flowchart TD
  P["假设 ALG 很大"] --> E["效率界:工作量太多<br/>OPT ≥ 总工作量 / 总能力"]
  P --> C["组合界:大 job 太多<br/>m+1 个 > OPT/2 的 job"]
  E --> X["矛盾"]
  C --> X
  D["Doubling:去掉“已知 OPT”"] -.-> P
  G["分层:每层损失常数,共 log m 层"] -.-> P
练习
练习 1:MR 中为什么 必须是按 Greedy 放的
在 MR 的最小反例中,为什么可以断定最后一个 job 被放在机器 上?这一步为什么对后面的论证重要?
答:若它被放在 ,算法当时判定”不危险”:,这台机器的最终负载就不超过 ,与反例矛盾。放在机器 意味着它叠在最低的机器上,开始位置 是当时的最小负载,于是所有机器的负载都 。这是后面”所有机器都满、每台都有 filling job”的出发点,也让效率界给出 。
练习 2:实时模型中 Greedy 的紧例子
实时到达时,Greedy(job 一到就放到当前最闲的机器上并开始)的竞争比是否仍然可以接近 ?
答:可以。让所有 job 都在时刻 释放,按 1.2 节紧例子的顺序到达:先 个单位 job,最后一个大小为 的 job。Greedy 一到就分配,行为与列表模型完全相同,;OPT 不受释放时间限制,仍为 。在线 LPT 则会先做大 job。
练习 3:Slow fit 为什么选"最慢"的可行机器
若改为放到”最快的可行机器”上,5.5 节的引理在哪一步失效?用 5.4 节的例子说明会发生什么。
答:引理的关键一步是”slow fit 选了比 快的机器,说明 不可行”。若规则是选最快的可行机器,选快机器不能说明慢机器不可行,链条断裂。在 5.4 节的例子中(取 ),选最快可行机器会像 Greedy 一样先把小 job 堆到快机器上,直到 的上限;后来的大 job 放在慢机器上太慢,放在快机器上又超限。直接模拟可以验证:层数 时会出现找不到可行机器的 job,而 slow fit 始终能放下,所有负载都 。选最慢的可行机器,是把快机器的容量留给只有它们才能及时处理的 job。
练习 4: 不是 的幂
6.2 节的下界构造要求 是 的幂。对一般的 ,能得到什么下界?
答:只在其中 台机器上运行构造,其余机器对所有 job 都不可用()。下界为 ,仍是 。